이 글의 본문은 글에서 설명한 변환기가 한글판을 --preset modern으로 자동 변환한 결과이며, 본문은 사람이 손보지 않았다. 제목과 요약만 손으로 고쳤다. 中意적(중의적), 地表(지표), 蘭語(난어) 같은 오선택은 1920–1962년 신문 어휘에 치우친 학습 데이터에서 온 것으로, 이것이 이 변환기의 현재 수준이다. 중국어 원문.
論文版은 arXiv(cs.CL)에 提出했고 DOI는 公開 後 적는다. 轉載 時 著者 Qifeng Xu(ORCID 0009-0009-1584-1519)와 出處 shan.ink를 밝혀야 한다.
현황
昨年에 한글–漢字 衆議성 解消 모델의 設計를 썼고, 設計案에서 멈춰 있었다. 이번에는 그것을 실제로 돌아가는 變換機로 만들었다. 순한글 韓國語 文章을 넣으면 國漢混用 文章이 나온다.
정부는 발전소 건설과 경제 발전을 위해 공사를 시작했다.
政府는 發電所 建設과 經濟 發展을 위해 工事를 始作했다.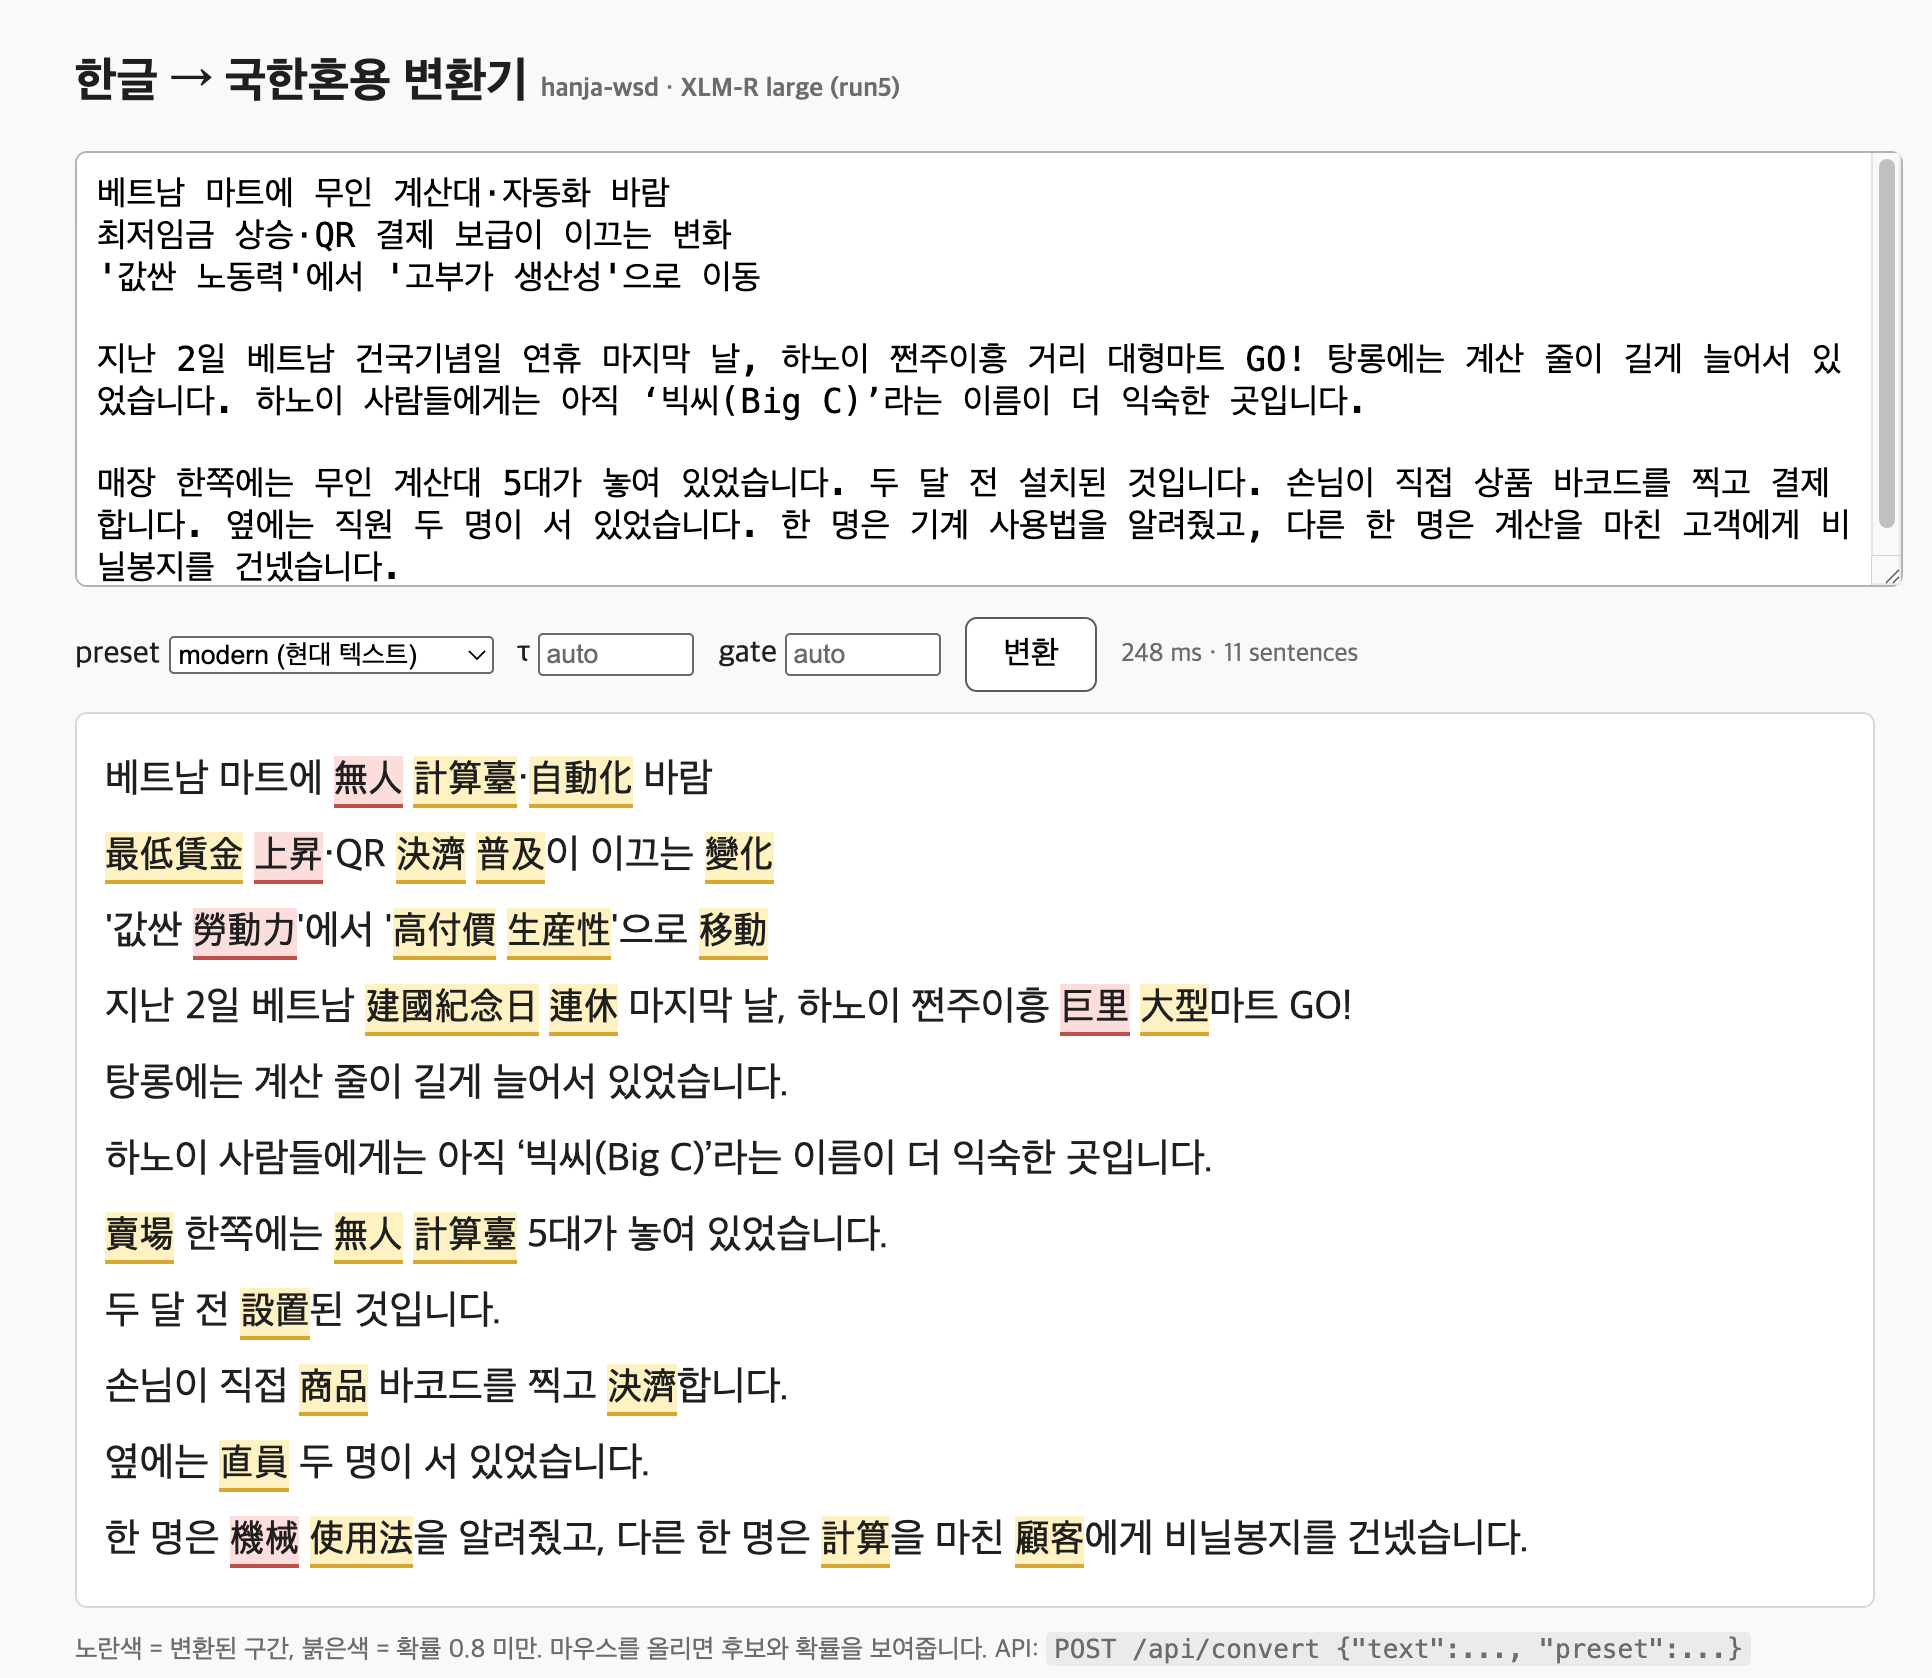
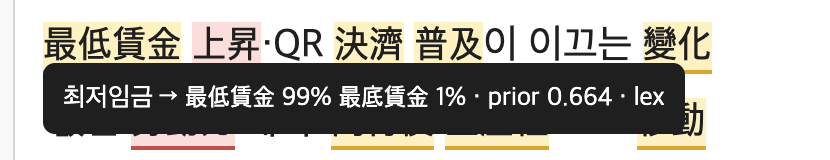
示演 페이지에 넣은 現代 新聞 記事 한 토막이다. 11文章, GPU에서 248 ms. 기계→機械, 결제→決濟, 직원→職員 같은 現代 常用語는 맞았고, 거리→巨里는 틀렸다. 街는 1920–1962年 新聞에서 거리로 거의 나타나지 않는다. 區間에 마우스를 올리면 候補와 確率이 보인다.
만들기 전에 問題의 크기부터 쟀다. 1920–1962년 國漢混用 新文 텍스트에서 두 音節 以上의 漢字語 토큰은 9,597만 개이고, 그 가운데 3분의 1이 中意적인 한글 形態(같은 한글 表記가 여러 漢字語에 對應)에 놓인다. 이 토큰들에 대해 가장 흔한 漢字만 고르면 正確度 89.1%다. 다시 “100회 以上 나타나고 最貧 한자 正確度가 90% 以下”인 難語로 좁히면 1,565개 形態, 全體 토큰의 10.8%이고 基準線은 70.8%다. 發電(發展/發電) 0.58, 公社(工事/公使/公社) 0.48, 婦人(婦人/否認/夫人) 0.37. 모델의 價値는 이 1할의 토큰에 集中된다.
| 地表 | 값 |
|---|---|
| 두 音節 이상 漢字語 토큰 | 95,972,811 |
| 中意적 한글 形態에 놓인 比率 | 33.4% |
| 최빈 한자 基準線(중의 토큰) | 89.1% |
| 難語(100회 以上, 基準線 90% 以下) | 1,565 形態, 토큰의 10.8% |
| 蘭語 基準線 | 70.8% |
目標
순한글 文段을 넣으면 國漢混用 文段이 나오고, 한자 選擇은 文脈이 潔淨하며, 固有語는 한글로 남긴다. 評價는 保留해 둔 新文 文章을 基準으로 한다. 區間 段位 P/R/F1(始作·끝 位置와 漢字가 모두 맞아야 正答)을 재고, “漢字를 잘못 고른” 比率은 따로 報告한다. 그것이 모델 自體를 反映하기 때문이다.
세 가지 制約이 以後의 모든 選擇을 決定했다. 첫째, 國立국어원의 語彙 意味 分析 말뭉치를 받을 수 없다. 申請書는 提出되지만 韓國 身分이 必要하므로 註釋 데이터는 전부 직접 만들었다. 둘째, 公開된 大規模 自然 註釋 텍스트는 1962년 吏典 新文뿐이다. 1963년 以後 本文은 著作權 때문에 除去되어 있어 學習 데이터의 言語가 現代 韓國語보다 半世紀 오래되었다. 셋째, 이 主題를 보는 사람은 누구나 “왜 LLM을 바로 쓰지 않는가”부터 묻는다. LLM은 같은 표에 基準線으로 들어가야 했다.
問題 定義
昨年 設計案은 이것을 다의어 중의성 解消로 다루었다. 실제로 漢字 變換에 必要한 것은 동형이의어의 區別, 즉 서로 다른 漢字語가 우연히 같은 表記를 갖는 境遇의 區別이다. 한 漢字語 안의 意味 項目은 區別할 必要가 없다. 레이블 空間은 “한글 形態 → 後補 漢字 集合”으로 줄고, 註釋도 “意味”에서 “어느 漢字로 쓰였는가”로 내려간다. 뒤에서 混用 텍스트로 學習 데이터를 自動 生成할 수 있었던 前提가 이것이다.
候補 集合에는 “變換하지 않음”도 있어야 한다. 신은 神일 수도 腎일 수도 있지만 固有語 신(신발)일 수도 있다. 變換機는 固有語를 한글로 남길 수 있어야 하고, 그렇지 않으면 모든 音節에 한자를 붙이게 된다.
데이터
| 出處 | 규모 | 용도 |
|---|---|---|
Open Korean Historical Corpus, newslibrary 부분집합 | 1920–1962년 混用 新聞, 濾過 후 10,046,459 文章 | 學習과 評價의 本體 |
| 韓國語 위키百科 “한글(漢字)” 括弧 註釋 | 835,825건 | 現代 텍스트 補強 學習과 評價 |
| 나무위키 括弧 註釋 | 303,743건 | 위와 같음 |
| gongu(퍼블릭 도메인 文學), 雜誌 | 139,052 + 28,227건 | 補講 學習 |
| kaikki(英語 위키낱말辭典 抽出) + 韓國語 위키낱말辭典 | 檢證된 한글–漢字 對應 41,519쌍 | 辭典 씨앗 |
Unihan kHangul + kaikki 單一 漢字 項目 | 8,525 + 7,727자의 음 | 음 生成과 檢證 |
混用 텍스트는 그 自體가 註釋이다. 각 漢字語의 한글 음은 字母 음 표에서 生成할 수 있고, 規則은 어두 두음法則(ㄹ→ㄴ/ㅇ, ㄴ+i/y 母音→ㅇ)과 語中 렬/률→열/율뿐이다. 檢證된 辭典 對應 41,518쌍으로 試驗하면 規則 正確度 98.95%이고, 나머지 誤謬는 거의 북한식 表記다. 거꾸로 混用 文章의 漢字를 모두 生成된 음으로 바꾸면 순한글 文章과 正答 區間이 나온다. 學習 레코드는 2,147만 건이고, 각 레코드는 “文章, 對象 單語 位置, 正答 한자, 候補 目錄”이다.
社殿은 세 층을 겹쳐 만들었다. 음 檢證을 거친 위키낱말辭典 對應, 新文에서 캔 183만 개 漢字열(3회 異常 出現)에 生成된 음을 붙인 것, 그리고 각 括弧 註釋의 學習 페이지 部分. 합치면 한글 形態 231만 개, 그중 14만 개가 中意적이다. 음 檢證 段階에서 오대응 5,219쌍이 걸러졌고, 그중에는 위키낱말辭典 項目 說明에서 온 朝鮮→高麗 같은 誤謬도 있었다.
異體字는 統一해야 한다. 같은 單語가 新文에서 塲과 場, 决과 決, 糓과 穀으로 적혀 있는데, 합치지 않으면 서로 競爭하는 候補가 되어 모델이 標準 表記를 골라도 誤答 處理된다. 對應표는 Unihan의 kZVariant에 수작업을 더했고, 방향은 現代 辭典의 用字를 基準으로 했다. 첫 판은 “어느 글자가 辭典에서 흔한가”로 方向을 정했는데, 그러면 姓氏 朴이 樸으로 합쳐져 朴氏 人名이 전부 틀린다. 지금 規則은 두 글자가 모두 韓國語 單語에 쓰인 적이 있으면 합치지 않는 것이다.
위키百科와 나무위키의 括弧 註釋에는 뚜렷한 選擇 偏向이 있다. 筆者가 中意적이라고 느낀 곳에만 括弧를 달고, 大部分이 地名, 干支 年號, 王朝, 人名이다. 나무위키 註釋에서 最貧 한자 基凖線은 36.9%에 불과하다. 이 두 出處는 어려운 評價 集合으로는 適合하고, 單獨 學習 데이터로 쓰면 모델을 固有名詞 쪽으로 치우치게 한다.
候補 生成
순한글 文章에서 먼저 어떤 區間이 漢字語일 수 있는지 찾아야 한다. Kiwi로 형태소 分析을 한 뒤 한글 連鎖 안의 2~8音節 部分 문자열을 모두 辭典에서 찾고, 있는 것을 候補 區間으로 삼는다. 겹침은 뒤의 選擇 段階에 맡긴다. 이 층의 指標는 再現율, 즉 正答 漢字가 候補 集合 안에 있는 比率이다. 保留 新文 文章에서 90.6%이고, 글자 單位 組合 對體 經路(각 音節을 可能한 漢字로 되찾고, 新文 漢字열로 學習한 글자 바이그램 言語모델로 빔 探索해 相違 10개)를 더하면 97.8%다.
Kiwi의 名詞 境界만 쓰면 再現율이 60%에 그친다. Kiwi는 완전히를 富士로 標誌하고, 옛 表記에서는 형태소 분석 字體가 不正確하다. 놓친 單語의 折半이 이런 境遇였다. 境界를 전혀 보지 않고 한글 連鎖 全體에서 部分 문자열을 세면 再現율은 오르지만 1920年代 텍스트에서 語節 境界를 가로지르는 오매칭이 大量으로 생긴다. 파견책에서 譴責을, 그리하야에서 以下→以下를 잡아낸다. 最終 規則은 軀幹이 Kiwi 형태소의 始作에서 始作해 형태소의 끝에서 끝나야 하되 品詞는 制限하지 않고, 다만 軀幹이 덮는 모든 형태소가 名詞類여야 한다는 것이다. 뒷조건은 시연 중에 建設과가 통째로 建設課로, 危害가 危害로 바뀌는 것을 보고 追加했다. 助詞와 語尾가 區間 안에 들어가면 안 된다.
위키百科 評家 集合에서 再現율은 81%에 머문다. 나머지는 어떤 辭典에도 없는 人名과 地名이고, 글자 組合이 그중 4분의 1을 건진다.
採點 모델
構造는 cross-encoder다. “對象 單語를 表示한 文章” 와 “候補 漢字 하나” 를 함께 넣으면 모델이 그 組合에 點數 를 주고, 같은 레코드의 候補 集合 에 softmax를 適用해 交叉 엔트로피로 學習한다.
이 設計는 인코더가 漢字를 알아야 成立한다. XLM-R의 토크나이저는 사전 漢字 가운데 0.54%만 미지 文字로 處理하고, 化粧은 化와 粧으로, 發電은 한 單位로 나눈다. KLUE-RoBERTa는 韓國語 전용 모델이라 토크나이저가 漢字를 거의 모르고, 候補가 未知 文字가 되면 모델은 單語 形態로 답을 외우는 수밖에 없다. 結果는 難語에서 0.513으로 最貧 한자 基準線보다 낮다.
學習은 V100 8장에서 데이터 병렬로 했다. V100은 16 GB뿐이라 large 모델은 張當 레코드 4건 × 候補 12개도 들어가지 않고, gradient checkpointing을 켜서 張當 13.8 GB로 맞췄다. DDP는 모든 파라미터가 loss에 參與하기를 要求하는데 인코더에 딸린 pooler는 쓰이지 않으므로 로드 시 꺼야 한다. 프로세스 8개가 각각 800만 건을 통째로 읽으면 160 GB 메모리가 바닥나므로 각 프로세스가 自己 分割만 읽게 했다. 分割 길이가 한두 건 다르면 프로세스마다 스텝 수가 달라져, 먼저 끝난 쪽은 barrier에서, 아직 도는 쪽은 all-reduce에서 서로 기다리다가 NCCL 時間 超過로 學習 프로세스는 죽고 torchrun은 남아 作業이 RUNNING에 걸린다. 分割 길이의 최솟값을 all-reduce로 맞춰 解決했다.
난어 評價 集合(7,263 區間) 結果:
| 시스템 | 正確度 |
|---|---|
| 최빈 漢字 | 0.708 |
| KLUE-RoBERTa base, 200만 건 | 0.513 |
| XLM-R base, 200만 건 | 0.815 |
| XLM-R large, 200만 건 | 0.872 |
| XLM-R base, 800만 건 | 0.892 |
| XLM-R large, 200만 건 + 現代 柱石 ×2 | 0.892 |
| claude-sonnet-4-6(候補 集合 내 選擇) | 0.920 |
| XLM-R large, 400萬 件 + 現代 註釋 ×2 | 0.908 |
| XLM-R base, 2,150萬 件(全量) + 現代 註釋 ×2 | 0.947 |
데이터 양이 모델 크기보다 重要하다. base는 200만에서 800만 건으로 7.7포인트 올라 200만 건의 large를 넘었다. 現代 註釋은 歷史 難語에는 影響이 없고 現代 텍스트에는 크게 作用해, 위키百科 評家 集合이 0.528에서 0.818로, 나무위키가 0.574에서 0.782로 올랐다.
LLM 基凖線은 같은 候補 集合과 같은 標本으로 모델 6개를 하나씩 돌렸고, 모델당 150건이다. 新文의 普通名詞에서 LLM은 最貧 한자 基準線과 같은 水準(0.92 대 0.89~0.94)이고 蘭語에서만 差異가 난다. 基準線을 돌리며 얻은 經驗: 게이트웨이는 同時 要請에 敏感해 프로세스 16개를 한꺼번에 보내면 전부 429였고, 모델 하나씩 同時性 3에 止宿 백오프로 바꿨다. 推論형 모델은 出力 上限을 2048 토큰으로 올리고 應答의 마지막 숫자를 취해야 한다.
變換 與否
採點 모델은 “이 區間이 어느 한자인가”에만 답하고 “이 區間을 變換해야 하는가”에는 답하지 못한다. 候補가 하나뿐이면 softmax는 반드시 1.0이고, 아침은 社殿의 쓰레기 項目 俄枕에 잡힌다.
여기에 漢字化 事前確率을 썼다. 한글 形態 에 對해 混用 新聞에서 漢字로 적힌 回數 와 한글로 적힌 回數 를 센다.
筆者가 變換을 擇한 經驗的 確率로, 固有語는 0에 가깝고 漢字語는 1에 가깝다. 이것이 게이트로 作動해 인 區間은 選擇에 參與하지 못한다. 區間 選擇은 動的 計劃法으로, 候補 區間 集合 에서 겹치지 않는 部分集合 를 골라 다음을 最大化한다.
는 그 區間의 最善 候補의 softmax 確率이다. 긴 區間과 높은 信賴度가 優待되고, 인 區間은 한글로 남는다.
이 媒介變數들은 縱斷간 F1로 切除 實驗을 했고, 모두 保留 신문 1,000文章(正答 區間 8,313개)에서다.
| 設定 | P | R | F1 |
|---|---|---|---|
| 명사 영역, 게이트 없음 | 0.650 | 0.601 | 0.625 |
| 명사 領域, 게이트 0.1 | 0.694 | 0.601 | 0.644 |
| 連鎖 전체 部分 문자열, 게이트 0.3, τ 0.7 | 0.670 | 0.810 | 0.734 |
| 형태소 정렬, 게이트 0.3, τ 0.7 | 0.763 | 0.823 | 0.792 |
| 형태소 正列 + 區間 안에 비名詞 형태소 없음 | 0.810 | 0.802 | 0.806 |
게이트를 높이면 再現율까지 오른다. 事前確率이 낮은 쓰레기 區間이 빠지면 動的 計劃法이 그것들에 밀려 올바른 긴 區間을 놓치는 一二 없어진다. 단音節 接辭(的, 側, 黨)와 숫자·날짜 規則은 이 평가 集合에서 利得이 없었다. 날짜열이 한글 連鎖 가운데 끼어 있어 規則의 境界 條件이 잡지 못한다.
辭典確率은 1920–1962년 말뭉치에서 왔기 때문에 現代 固有名詞에는 너무 嚴格하다. 咸安郡 0.24, 甲子 0.07로 모두 0.3 아래다. 現代 텍스트는 게이트 0.05, τ 0.5로 바꾸었고 위키百科 再現율이 0.615에서 0.741로 올랐다. 變換기는 --preset historical|modern 두 가지 基本값을 提供한다.
종단간 結果
| 平家 集合 | 프리셋 | P | R | F1 | 漢字 오選擇 |
|---|---|---|---|---|---|
| 신문 1920–62, 完全 正答 (large, 200萬 + 現代) | historical | 0.810 | 0.802 | 0.806 | 2.4% |
| 新聞 1920–62, 完全 正答(base, 全量 + 現代) | historical | 0.766 | 0.866 | 0.813 | ≈2% |
| 위키百科, 括弧 正答 | modern | — | 0.741 | — | 12.8% |
| 나무위키, 括弧 正答 | modern | — | 0.691 | — | 15.6% |
新文에서 19%의 過剩 變換은 辭典確率로 나눠 보면 折半 以上이 말뭉치에서 대개 漢字로 적히던 形態다. 當時 筆者가 한글로 남기기로 한 單語들이다. 1950年代 以後 新文의 한글화 傾向이 뚜렷해 같은 單語가 두 記事에서 하나는 變換되고 하나는 되지 않으며, 이 部分의 precision은 評價의 下限이다. 위키百科에서는 precision을 잴 수 없다. 括弧는 筆者가 重義적이라고 느낀 單語에만 달려 있다.
現代 텍스트에서 잘못 고른 것은 人名과 地名에 몰려 있다. 金泳三 대 金永三은 文脈으로 풀 수 없다.
시연 서비스는 sto에서 돌아간다. CPU는 文章당 약 320 ms, V100은 文章당 24 ms이고 正確度는 같다.
모델 내려받기
두 체크포인트를 辭典, 事前確率 係數, 變換器 코드와 함께 Hugging Face에 올렸다. LinkinShan/hanja-wsd-base(全量 base, 歷史 텍스트와 速度 優先), LinkinShan/hanja-wsd-large(現代 텍스트에 조금 더 낫다). 加重値는 CC BY-NC-SA 4.0이며, 學習 데이터 中 나무위키의 NC-SA 條件이 加重値에 이어진다.
아직 하지 않은 것
- 200文章 수작업 檢討. 특히 “過剩” 部類는 그 單語가 當時에 漢字로 적혔을지를 사람이 判斷해야 한다.
- 全量 2,150만 건 레코드의 base와 400만 건의 large는 아직 學習 중이다.
- 국립국어원 말뭉치가 承認되면 現代 텍스트 評價에 비로소 正答이 생긴다.
- 人名과 地名은 지식 出處가 必要하고 文脈 모델로는 안 된다.
- 숫자와 날짜 規則 모듈을 現對 텍스트에서 다시 檢證한다.
參考
- Open Korean Historical Corpus, 데이터셋: 1920–1962년 昏庸 新聞의 出處. 著作權 除去에 관한 說明 包含.
- HanjaBridge: 모든 候補 한자를 모델에 提示하는 發想. 이 글의 候補 採點 設計와 對比된다.
- Don’t Just Scratch the Surface: Enhancing Word Representations for Korean with Hanja: 漢字가 韓國語 單語 表現에 미치는 效果.
- Beyond Distribution: Investigating Language Models’ Understanding of Sino-Korean Morphemes: 순한글로 學習한 모델의 漢字語 형태소 理解가 制限的이라는 結果. 다국어 인코더를 고른 根據.
- Unsupervised Cross-lingual Representation Learning at Scale: XLM-R.
- Kiwi: 형태소 分析과 형태소 境界.
- Unihan Database:
kHangul음과kZVariant異體 關係. - kaikki.org 위키낱말辭典 抽出, 韓國語 위키낱말辭典 漢字語 分類: 사전 씨앗.
- UTagger: 울산대학교의 형태소 分析·동형이의어 標識旗. 2011년에 이것을 中心으로 漢字 自動 變換을 만든 바 있어, 이 글과 가장 직접 이어지는 先行 시스템이다.