한국어판(한글) · 한국어판(국한혼용, 변환기 자동 생성)
论文版已投 arXiv(cs.CL),DOI 待公告后补上。转载请署名 Qifeng Xu(ORCID 0009-0009-1584-1519)并注明出处 shan.ink。
现状
去年写过一篇谚文汉字化消歧模型的设计,停在设计稿。这次把它做成了可以运行的转换器:输入纯谚文韩语,输出国汉混用文本。
정부는 발전소 건설과 경제 발전을 위해 공사를 시작했다.
政府는 發電所 建設과 經濟 發展을 위해 工事를 始作했다.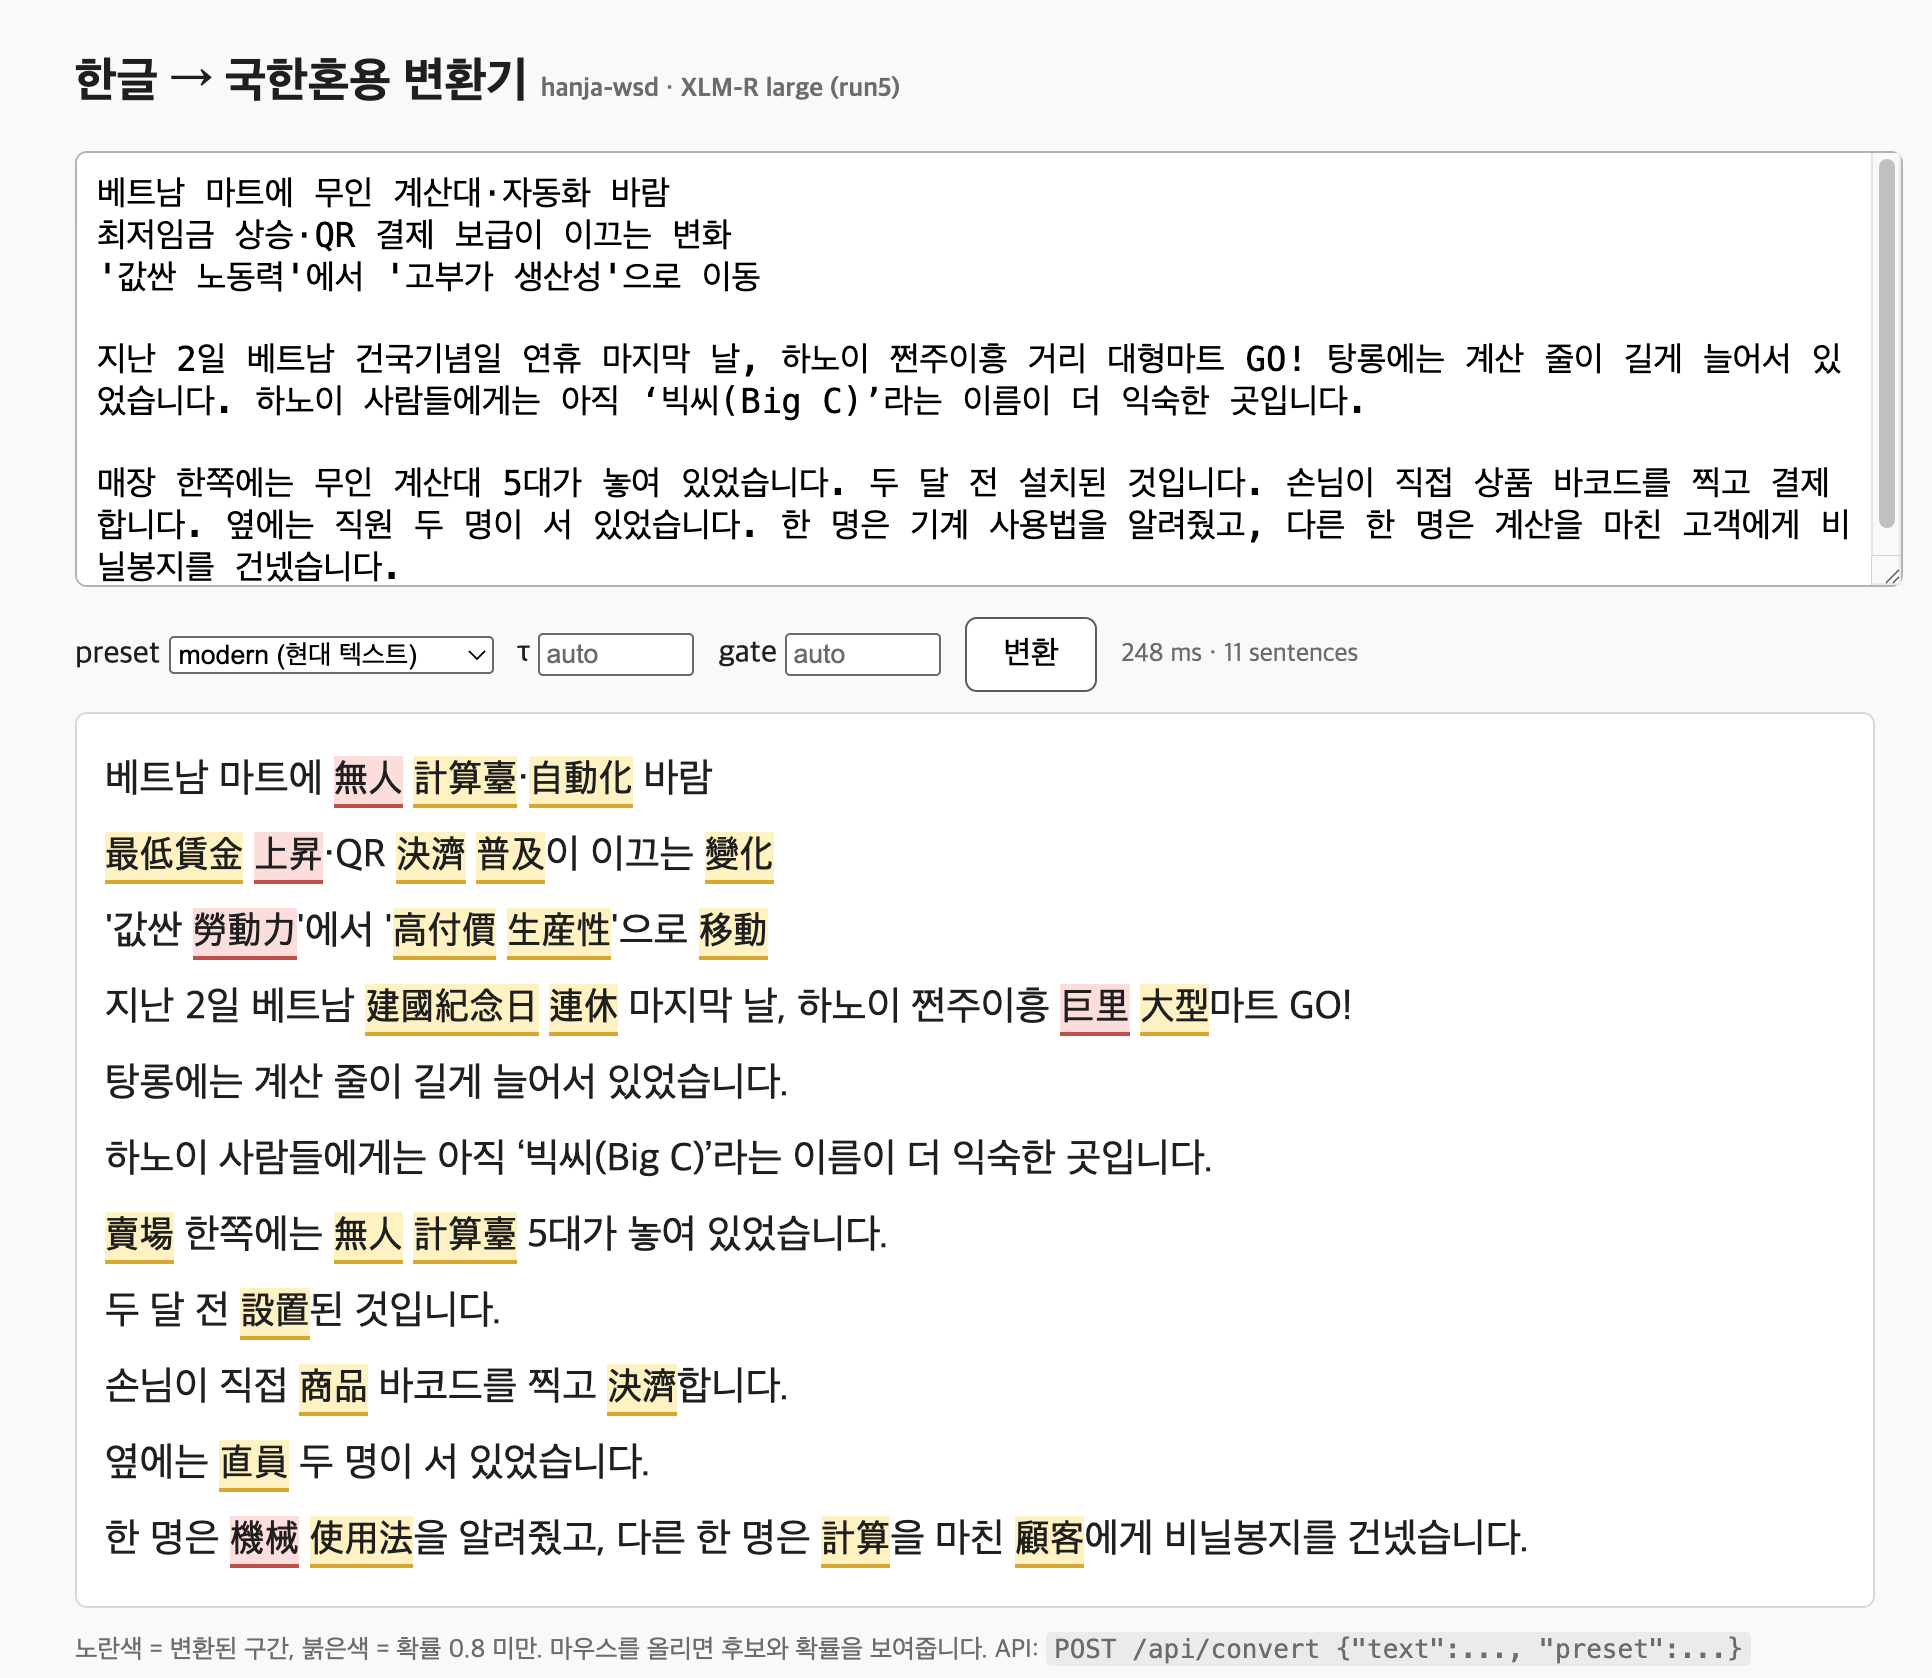
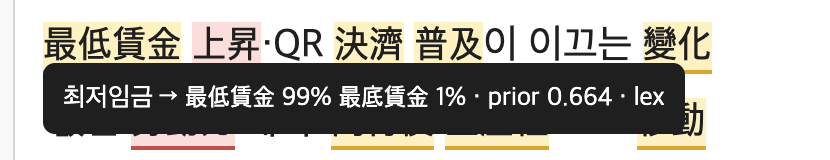
演示页上的一段现代新闻。11 句,GPU 上 248 ms。기계→機械、결제→決濟、직원→職員 这类现代常用词都对;거리→巨里 错了,街 在 1920–1962 年的报纸里几乎不以 거리 出现。鼠标移到任一区间可以看候选和概率:
做之前先量了问题有多大。在 1920–1962 年的混用报纸文本里,两字以上的汉字词共 9,597 万个 token,其中三分之一落在有歧义的谚文形上(同一个谚文写法对应多个汉字词)。对这些 token 只取最常见汉字,准确率 89.1%。再收窄到「出现至少 100 次、最常见汉字准确率不超过 90%」的难词,有 1,565 个谚文形,占全部 token 的 10.8%,基线只有 70.8%。발전(發展/發電)0.58,공사(工事/公使/公社)0.48,부인(婦人/否認/夫人)0.37。模型的价值集中在这一成 token 上。
| 指标 | 值 |
|---|---|
| 两字以上汉字词 token | 95,972,811 |
| 落在歧义谚文形上的比例 | 33.4% |
| 最常见汉字基线(歧义 token) | 89.1% |
| 难词(≥100 次且基线 ≤90%) | 1,565 形,10.8% token |
| 难词基线 | 70.8% |
目标
整段纯谚文文本进,整段混用文本出,汉字选择由上下文决定,固有语保持谚文。评估以留出的报纸句子为准:区间级 P/R/F1(起止位置和汉字全对才算),另外单独报告「选错汉字」的比例,因为它才反映模型本身。
三个硬约束决定了后面所有选择。第一,我拿不到国立国语院的语义标注语料,申请表能提交但需要韩国身份,所以标注数据全部自建。第二,唯一公开的大规模天然标注文本是 1962 年以前的报纸,1963 年起的正文因版权被移除,训练数据的语言比现代韩语老半个世纪。第三,任何人看到这个题目都会先问「为什么不直接用 LLM」,所以 LLM 必须作为基线出现在同一张表上。
问题定义
去年的稿子把它当多义词消歧做。实际上汉字化只需要区分同形异义(동형이의어),也就是不同的汉字词碰巧拼写相同;同一个汉字词内部的义项不用管。标签空间因此缩成「谚文形 → 候选汉字集合」,标注也从「义项」降级为「写成哪个汉字」,这是后面能靠混用文本自动生成训练数据的前提。
候选集里还要有「不转」这一项。신 可以是 神、腎,也可以是固有语的鞋。转换器必须能把固有语留在谚文,否则整段转换会给每个音节都配上汉字。
数据
| 来源 | 规模 | 用途 |
|---|---|---|
Open Korean Historical Corpus,newslibrary 子集 | 1920–1962 年混用报纸,过滤后 10,046,459 句 | 训练与测试的主体 |
| 韩文维基百科「한글(漢字)」括号标注 | 835,825 条 | 现代文本的训练补充与测试 |
| 나무위키 括号标注 | 303,743 条 | 同上 |
| gongu(公有领域文学)、杂志 | 139,052 + 28,227 条 | 训练补充 |
| kaikki(英文 Wiktionary 抽取)+ 韩文 Wiktionary | 41,519 组经验证的谚文–汉字对应 | 词典种子 |
Unihan kHangul + kaikki 单字条目 | 8,525 + 7,727 个汉字的读音 | 读音生成与验证 |
混用文本是天然标注:每个汉字词的谚文读音可以从字读音表生成,规则只有词首头音法则(ㄹ→ㄴ/ㅇ,ㄴ+i/y 元音→ㅇ)和词内 렬/률→열/율,对 41,518 组已验证的词典对应做检验,规则正确率 98.95%,剩下的错误几乎都是北韩式拼写。反过来,把混用句子里的汉字全部替换成生成的读音,就得到纯谚文句子加上金标区间。训练记录 2,147 万条,每条是「句子、目标词位置、正确汉字、候选列表」。
词典来自三层叠加:经读音验证的 Wiktionary 对应,从报纸挖出的 183 万个汉字串(出现 3 次以上)配生成读音,以及各括号标注的训练页部分。合并后 231 万个谚文形,14 万个有歧义。读音验证这一步去掉了 5,219 组错配,其中有 朝鮮→고려 这种来自 Wiktionary 词条描述的错误。
异体字要统一。同一个词在报纸里写成 塲 和 場、决 和 決、糓 和 穀,不合并的话它们会变成互相竞争的候选,模型选了标准写法反而被判错。映射表用 Unihan 的 kZVariant 加手工补充,方向以现代词典用字为准。第一版按「哪个字在词典里常见」决定方向,把姓氏 朴 并进了 樸,所有 박 姓人名全错;现在的规则是两个字都在韩语词里出现过就一律不合并。
维基和 나무위키 的括号标注有明显的选择偏差:作者只在觉得会歧义的地方加括号,而且绝大多数是地名、干支年号、朝代、人名。나무위키 标注上最常见汉字基线只有 36.9%。这两个来源当困难测试集合适,单独拿来训练会把模型往专名偏。
候选生成
纯谚文句子里先要找出哪些区间可能是汉字词。做法是用 Kiwi 分词,然后在谚文串里枚举所有 2 到 8 音节的子串查词典,命中的子串成为候选区间,重叠留给后面的选择步骤。这一层的指标是召回:正确汉字落在候选集内的比例。在留出的报纸句子上是 90.6%,加上逐字组合的后备(每个音节反查可能的汉字,用报纸汉字串训练的字二元语言模型做束搜索,取前十)到 97.8%。
只用 Kiwi 的名词边界召回只有 60%。Kiwi 把 완전히 标成副词,老拼写下的分词也不准,漏掉的词一半是这类。完全不管边界、整段谚文串都枚举子串,召回上去了,1920 年代的文本却出现大量跨词界误配:파견책 里抓出 견책,그리하야 里抓出 리하→以下。最后采用的规则是区间必须从 Kiwi 词元的起点开始、在词元终点结束,词性不限,但区间覆盖的每个词元都得是名词类。后一条是后来在演示里发现 건설과 被整段转成 建設課、위해 转成 危害 才加的,助词和动词语尾不能被包进区间。
在维基测试集上召回只有 81%,剩下的是人名地名,任何词典都没有。逐字组合能救回其中四分之一。
打分模型
架构是 cross-encoder:输入「标出目标词的句子」 加「一个候选汉字」,模型给这个组合一个分数 ,同一条记录的候选集合 做 softmax,交叉熵训练:
候选汉字作为文本输入,模型可以对没见过的汉字串打分,因为汉字本身带语义。
这个设计要求编码器认识汉字。XLM-R 的分词器对词典里的汉字只有 0.54% 未知字元,化粧 分成 化 和 粧,發電 是一个整词。KLUE-RoBERTa 是韩语专用模型,分词器基本不认汉字,候选变成未知字元后模型只能靠词形背答案,结果在难词上 0.513,低于最常见汉字基线。
训练在 8 张 V100 上做数据并行。V100 只有 16 GB,large 模型每卡 4 条记录乘 12 个候选就放不下,开梯度检查点后每卡 13.8 GB。DDP 要求每个参数都参与 loss,编码器自带的 pooler 用不到,得在载入时关掉;8 个进程各载一份 800 万条记录会把 160 GB 内存吃光,改成每个进程只载自己的分片;分片长度差一两条会让各进程步数不同,先跑完的在屏障上等,没跑完的在梯度同步上等,NCCL 超时后训练进程被杀而 torchrun 不退出,作业挂在 RUNNING。最后一条用 all-reduce 取各进程分片长度的最小值截齐。
难词测试集(7,263 个区间)上的结果:
| 系统 | 准确率 |
|---|---|
| 最常见汉字 | 0.708 |
| KLUE-RoBERTa base,200 万条 | 0.513 |
| XLM-R base,200 万条 | 0.815 |
| XLM-R large,200 万条 | 0.872 |
| XLM-R base,800 万条 | 0.892 |
| XLM-R large,200 万条 + 现代标注 ×2 | 0.892 |
| claude-sonnet-4-6(候选集内选择) | 0.920 |
| XLM-R large,400 万条 + 现代标注 ×2 | 0.908 |
| XLM-R base,2,150 万条(全量)+ 现代标注 ×2 | 0.947 |
数据量比模型大小重要:base 从 200 万到 800 万再到全量 2,150 万条,难词上 0.815 → 0.892 → 0.947,全量的 base 超过了 400 万条的 large(0.908),也超过了 LLM 基线。现代标注对历史难词没有影响,对现代文本影响很大,维基测试集从 0.528 到 0.817,나무위키 从 0.574 到 0.789;历史数据加多反而让现代文本略降,全量 base 在维基上是 0.772。
LLM 基线用同一个候选集、同一批样本,6 个模型逐个跑,每模型 150 条。在报纸普通名词上 LLM 和最常见汉字基线持平(0.89 到 0.94 对 0.92),在难词上才拉开。跑基线的经验:网关对并发很敏感,16 个进程同时打过去全是 429,改成单模型 3 并发加指数退避;思考型模型的输出上限得放到 2048 个 token,取回复里最后一个数字。
转换与否
打分模型只回答「这个区间该是哪个汉字」,回答不了「这个区间该不该转」。单一候选时 softmax 必然是 1.0,아침 会被词典里一个垃圾条目 俄枕 抓走。
这里用了一个汉字化先验。对谚文形 ,在混用报纸里数它以汉字写出的次数 和以谚文写出的次数 :
这是作者选择转换的经验概率,固有语接近 0,汉字词接近 1。它作为闸门: 的区间不参与选择。区间选择用动态规划,在候选区间集合 中取不重叠的子集 ,最大化
其中 是该区间最优候选的 softmax 概率。长区间和高置信度得到偏好, 的区间留在谚文。
这一组参数用端到端 F1 做了消融,都在留出的 1,000 句报纸上(8,313 个金标区间):
| 配置 | P | R | F1 |
|---|---|---|---|
| 名词区域,无闸门 | 0.650 | 0.601 | 0.625 |
| 名词区域,闸门 0.1 | 0.694 | 0.601 | 0.644 |
| 整段子串,闸门 0.3,τ 0.7 | 0.670 | 0.810 | 0.734 |
| 词元对齐,闸门 0.3,τ 0.7 | 0.763 | 0.823 | 0.792 |
| 词元对齐且区间内无非名词词元 | 0.810 | 0.802 | 0.806 |
提高闸门连召回都会上升,低先验的垃圾区间退出后,动态规划不再被它们挤掉正确的长区间。单字缀词(的、側、黨)和数字日期的规则在这个测试集上没有增益,日期串夹在谚文串中间,规则的边界条件抓不到。
先验来自 1920–1962 年的语料,对现代专名太严:함안군 0.24,갑자 0.07,都在 0.3 以下。现代文本改用闸门 0.05、τ 0.5,维基召回从 0.615 到 0.741。转换器提供 --preset historical|modern 两组预设。
端到端结果
| 测试集 | 预设 | P | R | F1 | 选错汉字 |
|---|---|---|---|---|---|
| 报纸 1920–62,完整金标(large,200 万 + 现代) | historical | 0.810 | 0.802 | 0.806 | 2.4% |
| 报纸 1920–62,完整金标(base,全量 + 现代) | historical | 0.766 | 0.866 | 0.813 | ≈2% |
| 维基百科,括号金标 | modern | — | 0.741 | — | 12.8% |
| 나무위키,括号金标 | modern | — | 0.691 | — | 15.6% |
报纸上的 19% 多余转换,按先验分桶后有一半以上的谚文形在语料里多以汉字书写,这些是作者当年选择留成谚文的词。1950 年代以后报纸谚文化趋势明显,同一个词在两篇文章里一个转一个不转,这部分 precision 是评估的下界。维基上 precision 无法评估,括号只标了作者觉得会歧义的词。
现代文本上选错的集中在人名地名:金泳三 对 金永三,上下文解不了。
演示服务跑在 sto 上,CPU 每句约 320 ms,V100 每句 24 ms,准确率相同。
模型下载
两个检查点连同词典、先验计数和转换器代码都在 Hugging Face:LinkinShan/hanja-wsd-base(全量 base,历史文本和速度优先)、LinkinShan/hanja-wsd-large(现代文本略好)。权重 CC BY-NC-SA 4.0,训练数据里 나무위키 的 NC-SA 条款传递到了权重上。
还没做的
- 200 句人工检查。特别是「多余」那一类,需要有人判断这个词当年会不会写成汉字。
- 国立国语院的语料如果批下来,现代文本的评估才有金标。
- 人名地名需要知识来源,上下文模型做不到。
- 数字和日期的规则模块在现代文本上再验一次。
参考
- Open Korean Historical Corpus、数据集:1920–1962 年混用报纸的来源,含版权移除的说明。
- HanjaBridge:把所有候选汉字呈现给模型的思路,与本文候选打分的设计对照。
- Don’t Just Scratch the Surface: Enhancing Word Representations for Korean with Hanja:汉字对韩语词表示的作用。
- Beyond Distribution: Investigating Language Models’ Understanding of Sino-Korean Morphemes:纯谚文训练的模型对汉字词语素的理解有限,支持本文选多语言编码器的理由。
- Unsupervised Cross-lingual Representation Learning at Scale:XLM-R。
- Kiwi:分词与词元边界。
- Unihan Database:
kHangul读音与kZVariant异体关系。 - kaikki.org Wiktionary 抽取、韩文 Wiktionary 한자어 分类:词典种子。
- UTagger:蔚山大学的形态素分析加同形语标注器,2011 年以它为核心做过汉字自动转换,是本文最直接的前人系统。